Gemini 生态解构:从应用封装到底层模型的差异辨析
Gemini 生态解构:从应用封装到底层模型的差异辨析
在这个大模型爆发的时代,Google 的 “Gemini” 标签下其实包含了完全不同的产品形态。很多用户在面对 Gemini 网页端、Gemini CLI 和 Google AI Studio 时感到困惑:它们到底有什么区别?我该用哪一个?
其实,很多人的困惑源于不理解它们背后的产品架构。
本文将剥离表象,从底层逻辑带你看懂这三个工具,并深入解析不同模型之间如 Gemini 3 Pro 与 Nano Banana Pro 的协作机制。
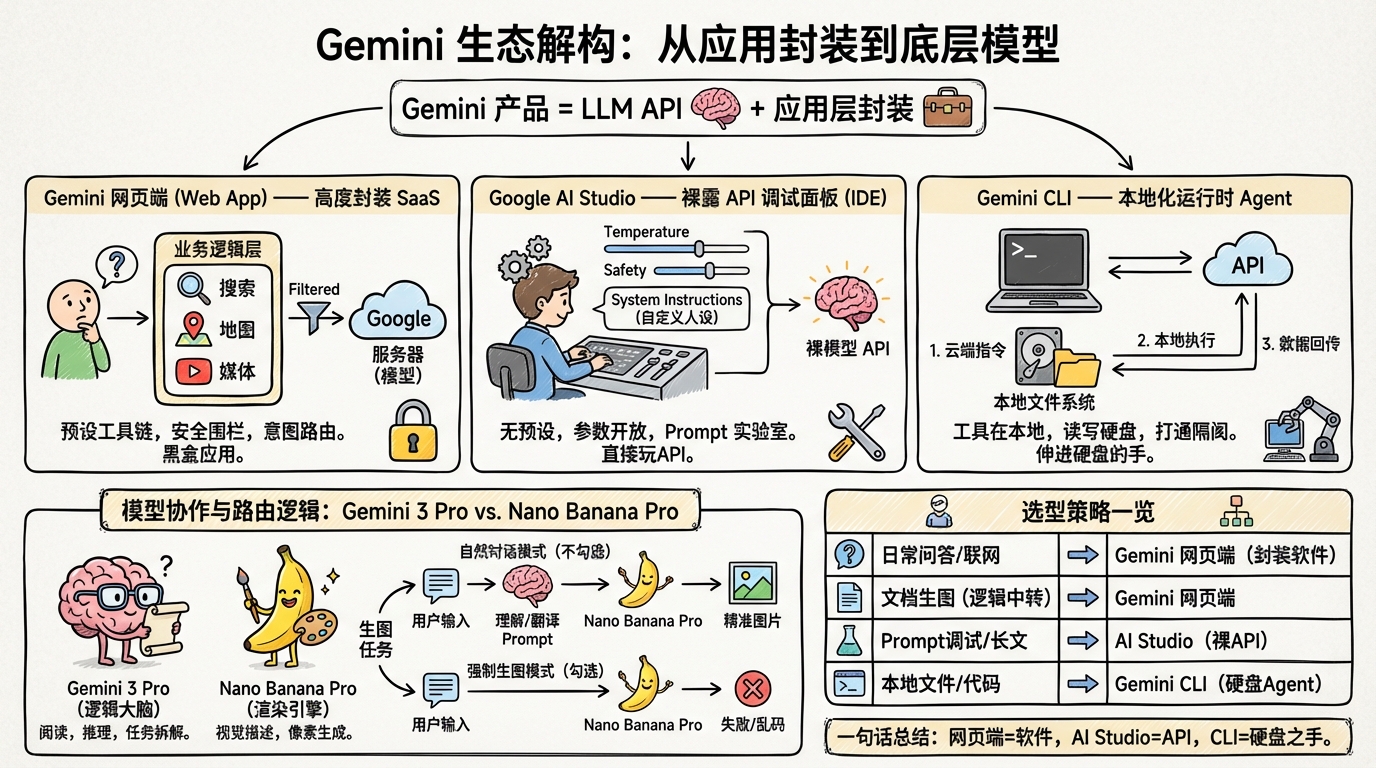
一、 核心概念:LLM API 与“应用封装”
要理解这三者的区别,首先要打破一个误区,在 gemini 网页或者 app 端:你并不是直接在和模型对话。
普通的 LLM API(大模型接口)本质上是“静态”的。* 它可以输入文本/图片,输出文本,但它本身不知道今天是几号,也无法上网。
“Gemini”作为一个产品,其实是:LLM API + 应用层封装(Orchestration Layer)。
举个经典的例子:
当你问:“今天天气怎么样?”
- 如果是裸模型(Raw LLM API):它会一脸茫然,因为它没有“今天”的时间概念,也没有联网能力。它可能会瞎编,或者告诉你“我只是一个模型”。
- 如果是 Gemini 网页端(Chat App):
- 应用层首先拦截你的请求。
- 系统会在后台动态插入当前的日期(Context Injection)。
- 系统会检测到意图,自动调用搜索工具(Search Tool)去查询天气。
- 最后,将搜索到的数据喂给模型,模型整理语言后输出答案。
理解了这个逻辑,我们就能看清三个工具的本质差异:
二、 三种工具的架构级拆解
1. Gemini 网页端 (Web App) —— 高度封装的“黑盒”应用
- 本质:这是一个完整的SaaS 产品。Google 在模型之上,封装了极厚的业务逻辑层。
- 封装内容:
- 预设工具链:内置了 Google Maps, Flights, YouTube 等工具,用户无法修改,只能被动使用。
- 安全围栏:后台有极严苛的 System Prompt(系统提示词)和安全分类器,过滤敏感内容。
- 意图路由:系统会自动判断你是要画图、搜索还是写作,并把任务分发给不同的模块。
- 局限:你是在用“别人配置好的软件”。如果你想让它按你的特殊格式输出(比如纯 JSON),或者想绕过某些安全限制,这一层厚厚的封装就会成为阻碍。
2. Google AI Studio —— 裸露的 API 控制台
- 本质:这是API 的调试面板(IDE)。它剥离了网页端那层厚厚的“业务逻辑”,让你直接面对模型本体。
- 控制权回归:
- 没有预设工具:这里没有谷歌航班、没有地图。你输入什么,模型就处理什么。
- System Instructions(系统指令):你可以自己定义“系统提示词”。比如你可以定义:“你不是聊天助手,你是一个 SQL 转换器,只输出代码”。而在网页端,你很难覆盖掉谷歌预设的“友善助手”人设。
- 参数开放:Temperature(随机性)、Safety Settings(安全过滤等级)全部向你开放。
- 价值:这是开发者的实验室。你在这里测试 Prompt,是因为这里没有网页端那些“干扰项”。
3. Gemini CLI —— 本地化的运行时环境
- 本质:这是一个将“工具层”部署在你本地的 Agent。
- 架构差异:
- Gemini 网页端的“工具”在 Google 的服务器上(比如搜索服务器)。
- Gemini CLI 的“工具”在你的电脑上(Shell 命令行、文件系统)。
- 工作流:
- CLI 将你的需求发送给云端的 API。
- API 返回一个指令:“请读取用户目录下的
report.pdf文件”。 - CLI 在本地执行这个读取操作。
- CLI 将文件内容再次发回给云端模型进行分析。
- 核心优势:它打通了云端大脑与本地系统的隔阂,这是网页端和 AI Studio 绝对做不到的。
三、 不同模型逻辑辨析:Gemini 3 Pro vs. Nano Banana Pro
在不同工具内部,封装着各种各种可用模型。模型之间既可以分开使用,也可以互相协作。比如在 Google ai studio 里,我们可以分别使用 gemini 3 pro 和 nano banana pro,而在 gemini 网页端,选择 pro 或者画图模式,则会让两个模型以不同逻辑协作完成任务。
以“生图”这个常见的任务为例,我们可以清晰地看到全能模型与垂类模型的协作关系。
1. 为什么有“两个”模型?
- Gemini 3 Pro(大语言模型):它是逻辑大脑。擅长阅读、推理、理解长文本、拆解任务。它本身不生成像素。
- Nano Banana Pro(图像生成模型):它是渲染引擎。它不具备复杂的逻辑推理能力,只听得懂视觉描述(Prompt),负责生成像素。
2. “Create image” 复选框的底层逻辑
在某些界面中,勾选“Create image”与否,实际上是在改变路由逻辑(Routing Logic)。
- 自然对话模式(不勾选):
- 你输入一段长文章让它配图。
- Gemini 3 Pro 先接管请求 -> 阅读理解 -> 提炼核心视觉元素 -> 翻译成英文绘图 Prompt -> 调用 Nano Banana Pro。
- 结果:图片精准、符合文章意境。
- 强制生图模式(勾选):
- 这相当于在系统层级注入了一条强指令:“忽略所有逻辑处理,直接调用生图工具”。
- 你输入长文章 -> Nano Banana Pro 直接接收。
- 结果:生图模型读不懂长逻辑,导致生成失败或乱码。
四、 总结与选型策略
基于以上架构分析,我们可以得出更精准的选型建议:
| 需求类型 | 推荐工具 | 底层逻辑 |
|---|---|---|
| 需要联网、查票、日常问答 | Gemini 网页端 | 利用其封装好的“搜索/生态工具链”和上下文注入能力。 |
| 需要通过复杂文档生图 | Gemini 网页端 | 利用 Gemini 3 Pro 的“逻辑中转”能力,先理解后绘图。 |
| Prompt 调试、长文档分析 | AI Studio | 利用其“无干扰”的裸模型环境和 Context Caching,避开网页端的系统预设干扰。 |
| 修改代码、整理本地文件 | Gemini CLI | 利用其将“Runtime”部署在本地的特性,获得对操作系统的读写权限。 |
一句话总结:
- 网页端是用谷歌封装好的软件。
- AI Studio 是直接玩API。
- CLI 是把 API 的手伸进了你的硬盘。
本文由作者按照 CC BY 4.0 进行授权